'CS/CSAPP 컴퓨터 시스템' 카테고리의 글 목록
Hello World
skylarcoding.tistory.com
9.1 물리 및 가상주소 방식
CPU가 쓰는 주소와 메모리의 실제 주소가 다를 수 있다.
- 물리 주소 지정 : CPU가 낸 주소 = 실제 메모리 주소 (단순한 임베디드에서 사용)
- 가상 주소 지정 : CPU가 낸 주소(가상 주소) 는 진짜 위치가 아니고, MMU(Memory Management Unit) 라는 하드웨어가 page table을 보고 실제 위치 (물리 주소) 로 바꿔준 다음에 메모리를 찾아간다.
CPU: "이 주소 줘" (가상 주소)
   ↓
MMU: "잠깐, 진짜 주소로 바꿔줄게" (page table 참조)
   ↓
실제 메모리: 진짜 위치에서 데이터 반환
9.2 주소공간
주소가 나열되는 범위에도 이름이 있다. 주소공간은 0,1,2,3… 처럼 0 이상의 정수 주소들을 모아 놓은 집합이다. 주소가 연속된 정수라서 선형 (linear) 주소 공간이라고도 한다.
| 가상 주소 공간 | 물리 주소 공간 | |
| 누가 쓰는지 | CPU가 생성하는 주소 | 실제 메모리 (DRAM) 주소 |
| 크기 | N = 2ⁿ 개의 주소 (n비트 주소) | M개의 주소(실제 메모리 크기) |
- 요즘 시스템은 가상 주소를 32 비트나 64 비트로 쓰는게 일반적이다. n 이 정해지면 가상 주소의 크기가 2ⁿ 으로 정해진다.
- 물리 주소 공간은 컴퓨터에 실제로 꽂힌 메모리 크기에 대응한다.
데이터 자체(바이트) 와 그 데이터의 속성(주소) 를 구분하여야 한다. 메모리의 바이트 하나는 가상 주소 하나와 물리 주소 하나를 둘 다 가질 수 있다. 같은 데이터에 있는 각각의 주소를 MMU가 연결해준다.
9.3 캐싱 도구로서의 VM
가상 메모리는 디스크를 본체, 메인 메모리(DRAM)을 캐시로 쓰는 구조이다.
기본 구조
- 가상 메모리의 내용은 원래 디스크에 있다고 본다.
- 프로그램의 데이터가 진짜로 저장되는 곳은 디스크이고, DRAM은 그중 일부를 잠깐 복사해둔 곳이라고 생각하는 모델이다.
- 가상 메모리 전체 = 디스크에 있는 거대한 바이트 배열
- DRAM = 그 배열 중 지금 자주 쓰는 부분만 복사해둔 캐시
- 이걸 페이지(page) 라는 고정 크기 블록으로 나눠서, 자주 쓰는 것만 메인 메모리(DRAM)에 올려둔다.
- 가상 페이지는 세 상태 중 하나이다.
- Unallocated : 아직 아무것도 배정되지 않음
- Cached : 현재 물리 메모리에 캐시되어 할당된 페이지들
- Uncached : 물리 메모리에 캐시되지 않은 할당된 페이지들
DRAM 캐시의 구성
캐시에서 원하는 걸 못 찾는 것을 미스라고 한다. DRAM 에서 미스가 나면 디스크까지 가야하는데, 디스크는 DRAM 보다 수십만배 느리다. 그래서 미스를 최대한 줄이는 방향으로 설계한다.
- 페이지를 크게 잡음
- 어느 페이지든 어느 자리에나 들어갈 수 있게 함(fully associative)
- 정교한 교체 알고리즘 사용
- 쓰기는 write-back(바뀐 페이지를 그때그때 디스크에 쓰지 않고, 쫓아낼 때 한 번에 씀)
페이지 테이블 (Page Table)
이 가상 페이지가 지금 DRAM 에 있는지 기록해 둔 표이다. PTE (Page Table Entry) 가 모인 배열이고, 물리 메모리에 저장되며 OS 가 관리한다. 각 PTE 에는 유효 비트가 핵심이다.
- valid = 1 → DRAM에 있음 (주소는 그 물리 페이지 위치)
- valid = 0 → DRAM에 없음 (디스크에 있거나, 아직 할당 안됨)
페이지 히트
MMU가 PTE를 봤더니 valid = 1 → 바로 물리 주소로 변환해서 접근
페이지 폴트
- valid = 0 → 예외 발생, OS 의 핸드러가 실행됨.
- 핸들러는 DRAM에서 쫓아낼 희생 (victim) 페이지를 고르고 (수정됐다면 디스크에 저장)
- 필요한 페이지를 디스크에서 올린 뒤
- 폴트를 냈던 명령어를 다시 실행.
- 히트 됨
접근하는 순간에야 페이지를 올리는 방식을 요구 페이징(demand paging) 이라고 부른다.
지역성
디스크가 느린데도 잘 돌아가는 이유는 지역성 때문이다. 프로그램이 한 시점에 쓰는 페이지 묶음 (워킹셋) 은 보통 작아서, 처음에 한 번 올리면 이후엔 계속 히트한다. 반대로 워킹셋이 물리 메모리보다 커지면 페이지를 계속 쫓아냈다 올렸다 하는 스레싱이 일어나 극단적으로 느려진다.
9.4 메모리 관리를 위한 도구로서의 VM
OS 가 프로세스마다 별도의 페이지 테이블을 제공하여, 각 프로세스는 자기만의 가상 주소 공간을 가진다. 이 구조 덕에 메모리 관리가 단순해진다. 다수의 가상페이지들이 같은 물리 페이지 하나에 매핑될 수 있다.
이 구조는 메모리 관리를 현저하게 단순화하였고, 메모리를 보호하기 위한 자연스러운 방법을 제공한다.
- 링킹
- 각 프로세스들이 동일한 기본 포맷을 사용할 수 있도록 한다.
- 로딩
- 실행 파일 내용을 미리 복사하지 않고, 가상 페이지를 만들어 PTE에 디스크의 위치를 저장한다. 실제 접근 시에 페이지 폴트를 통해 내용이 올라온다.
- 메모리 매핑 : 연속된 가상페이지를 임의의 파일 내의 임의의 위치로 매핑하는 개념
- 공유
- 공통 코드는 물리 메모리에 하나만 두고, 여러 프로세스의 PTE 가 같은 물리 페이지를 가리키게 한다.
- 물리 페이지 : DRAM(물리 메모리)를 페이지 크기로 나눈 칸 하나
- 공통 코드는 물리 메모리에 하나만 두고, 여러 프로세스의 PTE 가 같은 물리 페이지를 가리키게 한다.
- 메모리 할당
- malloc 등으로 연속된 가상 페이지를 받아도, 물리적으로는 흩어진 페이지에 매핑이 가능하다. 물리 메모리에서 연속된 빈 공간을 찾을 필요가 없다.
9.5 메모리 보호를 위한 도구로서의 VM
PTE에 권한 비트를 추가해서, MMU 가 주소를 변환할 때마다 접근 권한도 같이 검사한다. 다음의 상황을 막기 위해서.
- 읽기 전용 코드 영역 수정
- 커널의 코드와 데이터 읽기, 수정
- 다른 프로세스의 개인 메모리 읽기, 쓰기
- 공유 페이지를 허락 없이 수정
- SUP : 커널 모드에서만 접근 가능한 페이지인가? 커널 모드로 실행 중인 프로세스는 모든 페이지에 접근이 가능하다. 사용자 모드에서는 SUP = 0 인 페이지만 접근 가능.
- READ : 읽기 허용 여부
- WRITE : 쓰기 허용 여부
위반시에는, CPU가 일반 보호 오류를 일으켜 SIGSEGV 시그널을 위반한 프로세스로 보내서 커널 내의 예외 핸들러로 제어를 이동시킨다. 리눅스 쉘은 이를 segmentation fault 로 보고한다.
9.6 주소의 번역
주소 번역 개념의 수학적 수식은 다음과 같다. 실제로는 MMU + 페이지 테이블이 수행한다.
MAP: VAS → PAS ∪ ∅
MMU 는 VPN (비트 가상페이지 번호 virtual page number) 을 사용해서 적합한 PTE (Page Table Entry)를 선택한다. 이때, VPN 번호가 PTE 번호로 그대로 사용한다. PTE에서는 물리페이지 번호 (PPN Physical Page number) 을 돌려준다.
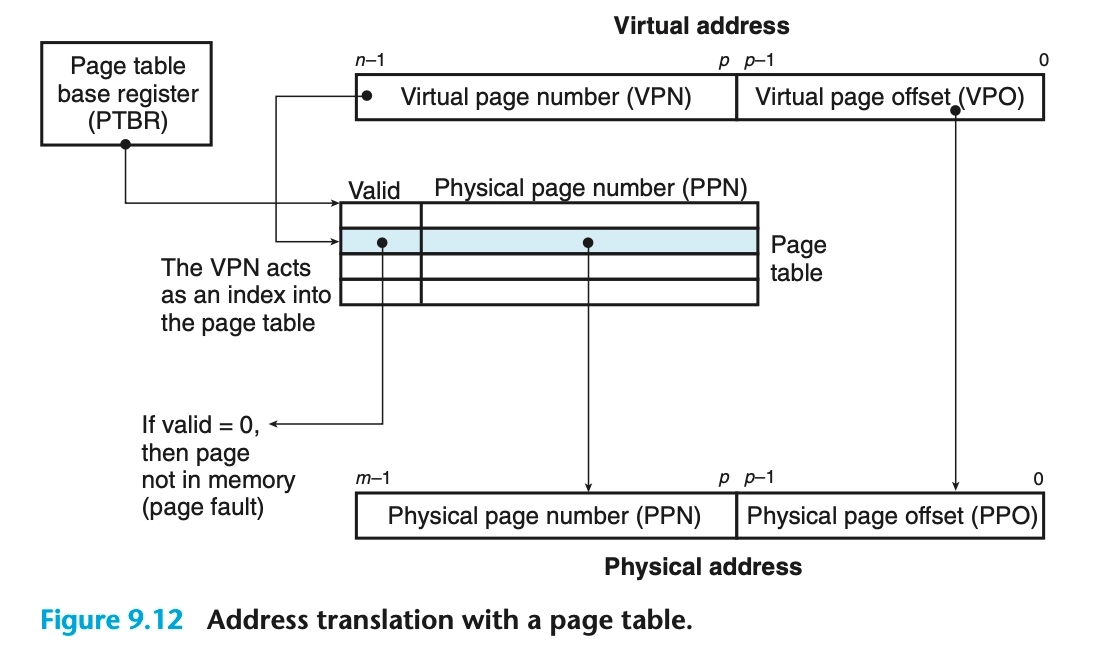
다음은 페이지 적중이 있을 때의 과정이다.
Virtual Address : VPN + VPO 로 구성되어있다.
- VPN (비트 가상페이지 번호) : (n-p) 비트 VPN, p 비트 VPO
Physical Address : PPN + PPO 로 구성되어있다.
- PPN (비트 물리페이지 번호) : (m-p) 비트 VPN, p 비트 PPO
Virtual Address 의 VPN 이 PTE 를 거쳐 PPN 값이 된다. VPO는 그 값 그대로 PPO 가 된다.
물리 주소 = [ PPN | PPO ] (PPO = VPO, 비트를 이어 붙임)
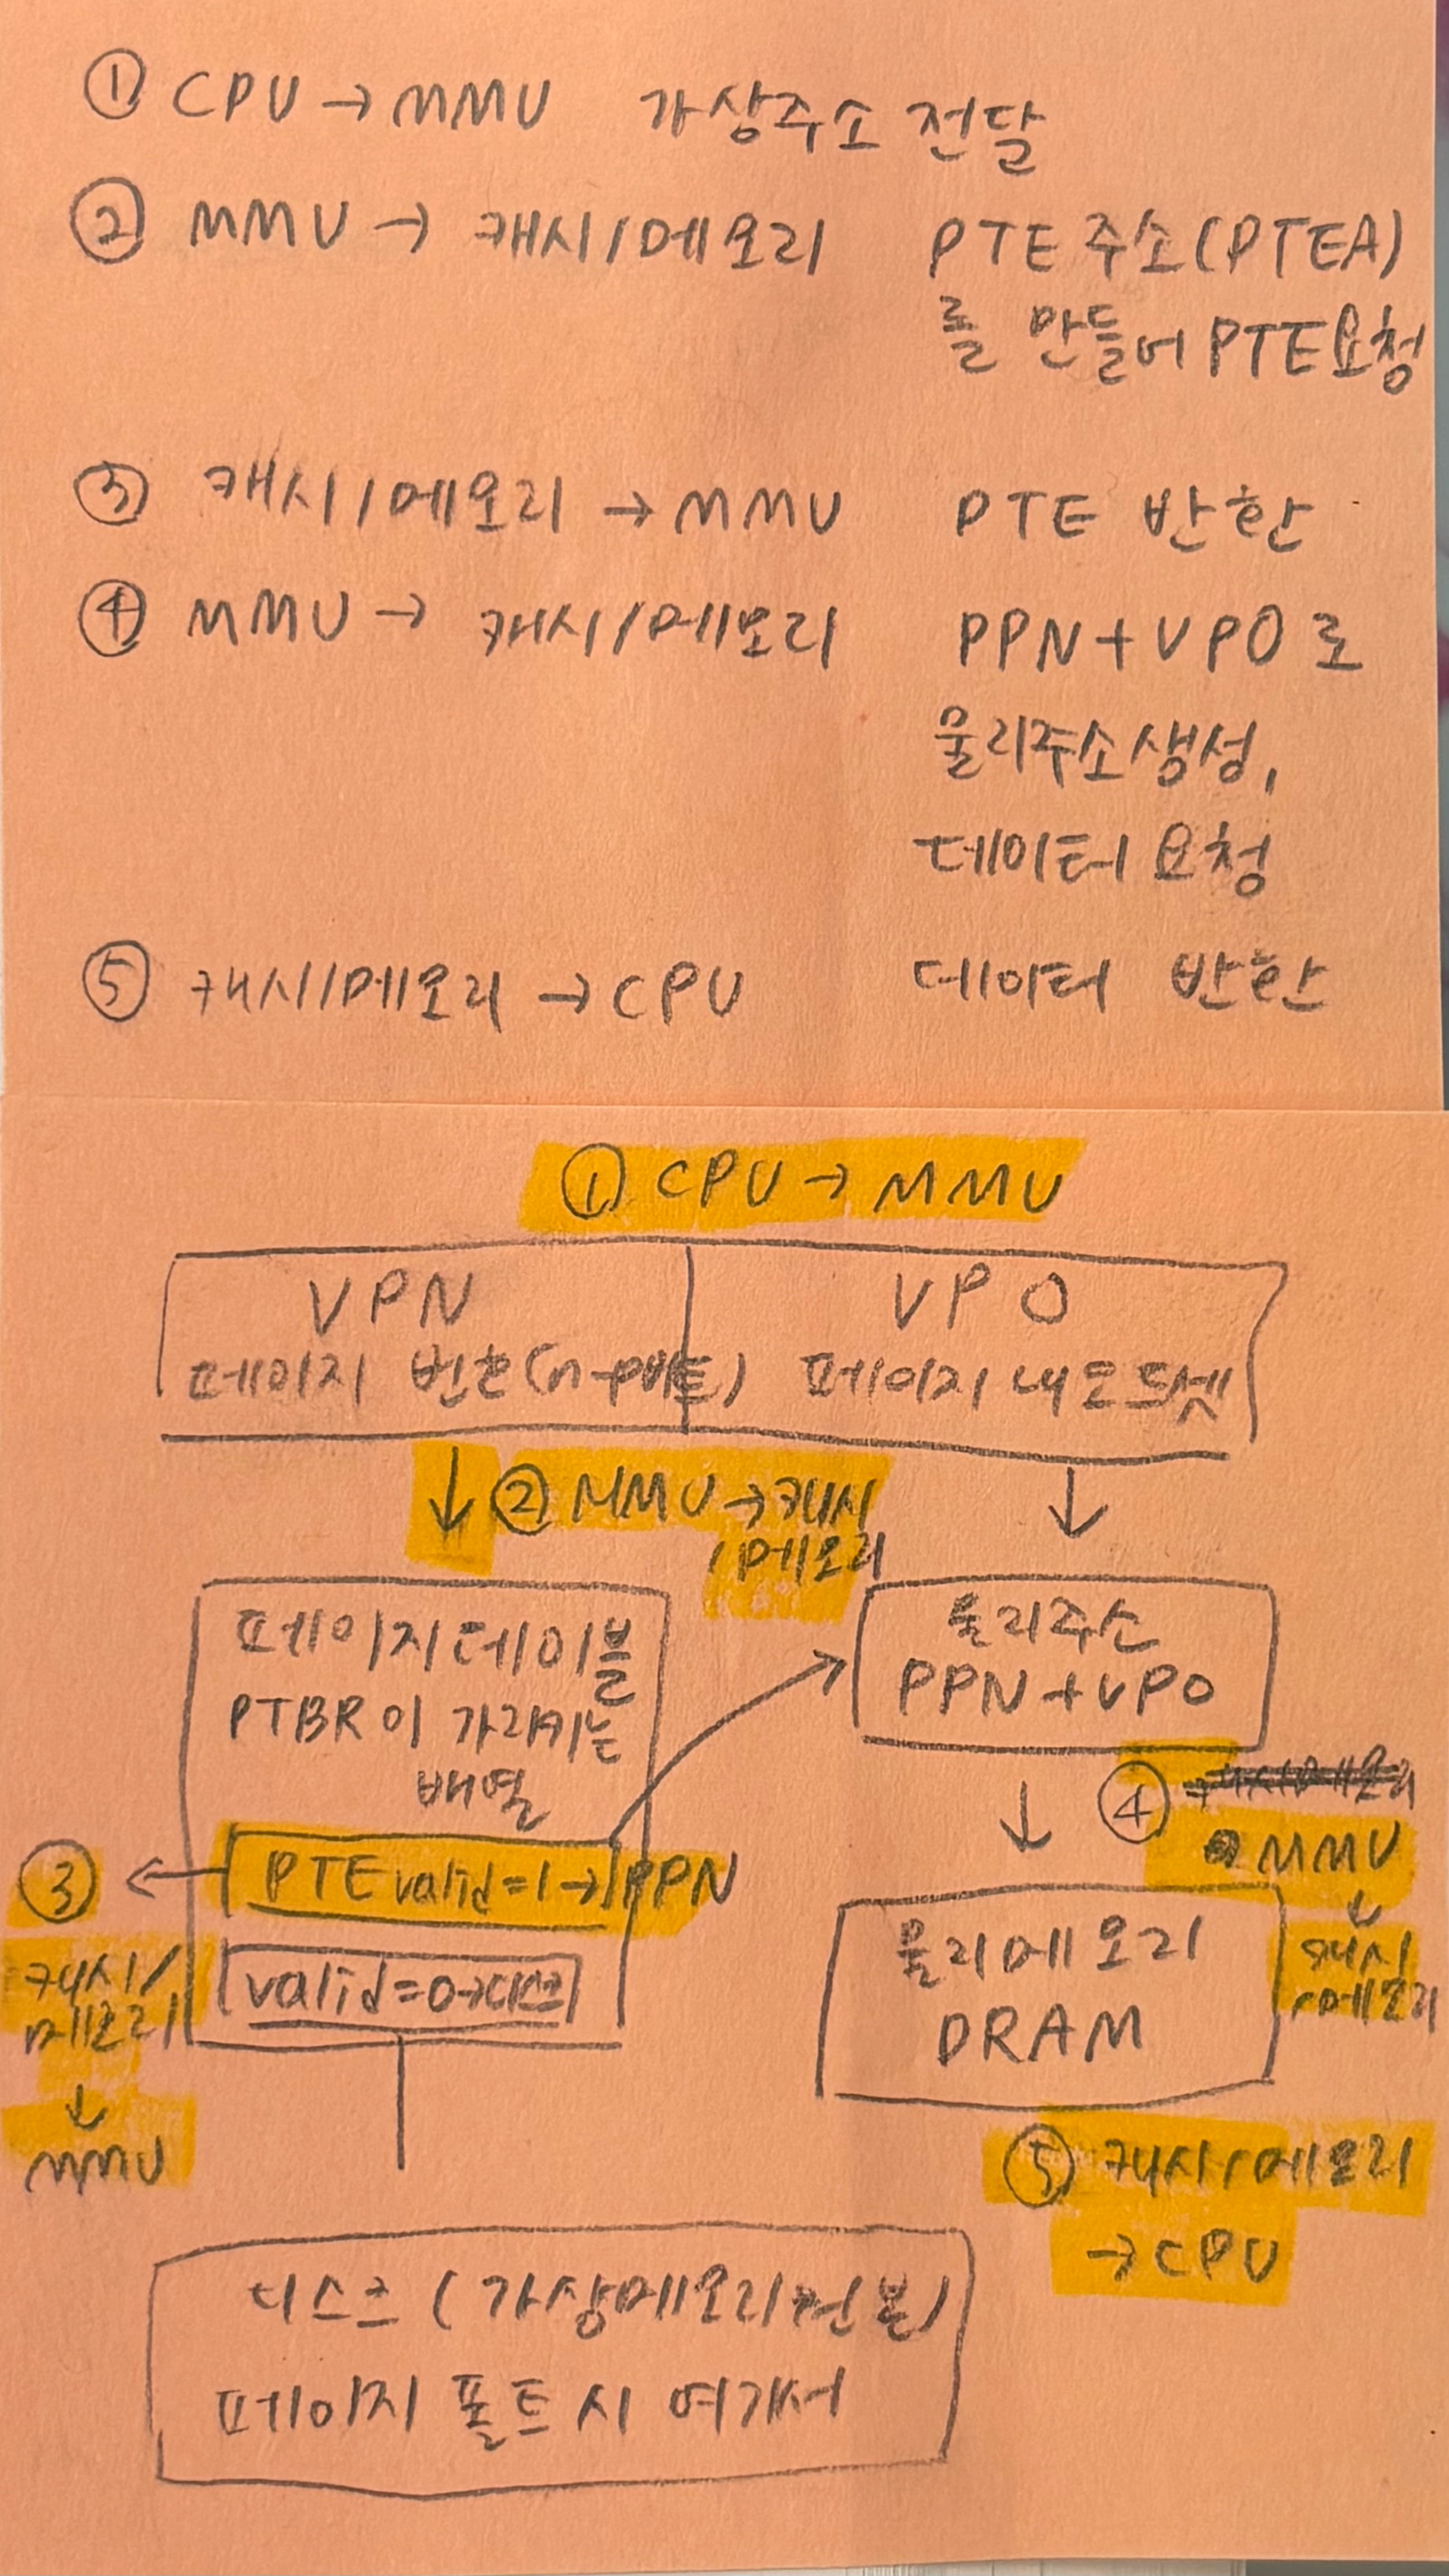
- CPU → MMU : 가상 주소 전달
- MMU → 캐시/ 메모리 : PTE 주소 (PTEA) 를 만들어 PTE 요청
- PTBR( 페이지 테이블 베이스 레지스터)가 현재 프로세스의 테이블 위치를 가리킨다. MMU가 PTE 주소를 만들 때 이 값이 출발점이 된다.
- 캐시/메모리 → MMU : PTE 반환
- MMU → 캐시/ 메모리 : PPN + VPO(PPO) 로 물리 주소 생성, 데이터 요청
- 캐시/메모리 → CPU : 데이터 반환
PT 는 캐시/메모리 에 들어있다. PTE도 일반 데이터처럼 L1 캐시에 캐싱될 수 있다.
페이지 오류(페이지 폴트) 처리 과정
- PTE 의 유효비트가 0임 → MMU 가 예외 발생시킴 → 커널의 페이지 오류 예외 핸들러로 이동
- 오류 핸들러가 물리 메모리 내 희생자 페이지를 결정 (어떠한 알고리즘으로 선택함) → 페이지가 수정되었다면 디스크로 페이지를 이동
- 희생자 페이지가 DRAM 에 올라온 뒤 내용이 바뀌었다면 DRAM의 최신본 디스크에 저장 ⇒ write-back
- 필요한 새 페이지를 디스크에서 물리 메모리로 가져옴 (page in) → 메모리 내의 PTE 갱신
- 오류 인스트럭션 재시작 → 페이지 적중
캐시와 VM의 통합
SRAM 캐시에 접근하기 위해 대부분의 시스템은 물리 주소지정을 선택한다. 물리 주소지정이란, MMU가 가상주소 → 물리주소 후 물리주소로 캐시를 조회하는 것을 말한다.
반대로, 가상주소로 찾는 캐시는 변환 전 가상주소로 캐시를 조회하는 것이다.
- 캐시를 물리 주소로 조회하면, 프로세스가 여러 개여도 "같은 주소 = 같은 데이터"가 항상 성립해서 캐시가 헷갈릴 일이 없다
- 접근 권한이 주소 번역 과정의 일부로 체크되기 때문에, 보호 이슈 다룰 필요가 없어진다.
TLB 를 사용한 주소 번역 속도의 개선
가상주소에서 물리주소로 번역하는 비용이 비싸다. 이를 개선하기 위해 MMU 내에 번역 참조 버퍼 (TLB) 라고 부르는 작은 캐시를 포함해서 비용을 줄인다.
TLB 는 PTE 만 담아두는 MMU 안 캐시이다. 대개 높은 수준의 결합성을 가진다.
- 결합성이 높다 : 같은 세트로 가는 VPN 이 여러개 있어도, 세트 안에 자리가 많아서 서로 쫓아내지 않고 함께 들어갈 수 있다
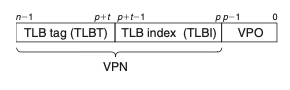
virtual address 의 VPN은 TLB tag 와 TLB index 로 이루어져 있다. TLB 히트 시 모든 주소 번역 과정이 MMU 내에서 수행돼서 매우 빠르다.
- TLBI = VPN의 하위 t비트(세트가 T = 2^t개)
- TLBT = VPN의 나머지 상위 비트
요청이 들어오면 → TLB 에서 찾고 → (미스면) 페이지 테이블에서 찾고 → (valid = 0 이면) 페이지 폴트 → OS 가 디스크에서 가져온다.
다중 레벨 페이지 테이블
페이지 테이블을 한 덩어리로 두면 너무 커서, 여러 단계로 쪼개고 필요한 부분만 만든다. 쪼개면 필요한 부분만 쓰게 돼서 메모리 차지가 줄어든다.
여러 단계로 나누는데, 첫번째 페이지 테이블은 무조건 메모리에 올라와서 찾는다. 다음 레벨에 없으면 2단계 테이블 자체를 만들 필요가 없다.
종단 주소 번역
- 진법 :
- 0~ 3까지 4개 표현은 2진법으로는 2비트가 필요하다
- 16진법은 2진법으로는 4비트가 필요하다
- 메모리는 바이트 주소지정이 가능하다
- 메모리 접근은 1바이트로 이루어진다 (4바이트 워드가 아니다)
- 가상주소들은 14비트 폭을 갖는다(n = 14)
- 물리 주소는 12비트 폭을 갖는다(m = 12)
- 페이지 크기는 64 바이트다 (P = 64)
- TLB 는 모두 16개의 엔트리를 갖는 4중 집합 결합도를 갖는다
- L1 d-캐시는 물리 주소를 가지며, 직접매핑을 사용하고, 4바이트 라인 길이 (2^2 = 2 bit), 16개의 전체 집합 (2^4 = 4 bit) 을 가진다.
가상 주소 (14비트)
13 ................. 6 | 5 ........ 0
        VPN (8비트)    |  VPO (6비트)     ← P = 64 = 2^6
[ TLBT 6비트 | TLBI 2비트 ]               ← TLB 세트 = 16 / 4 = 4 = 2^2

물리 주소 (12비트)
11 ........ 6 | 5 ........ 0
  PPN (6비트)  |  PPO (6비트)
[ CT 6비트 | CI 4비트 | CO 2비트 ]         ← 세트 16 = 2^4, 블록 4 = 2^2