'CS/CSAPP 컴퓨터 시스템' 카테고리의 글 목록
Hello World
skylarcoding.tistory.com
3.8 배열
배열 원소를 가리키는 포인터를 만들고 그 포인터로 산술 연산을 할 수 있다는 점이 특이하고, 전부 주소 계산으로 번역된다.
기본 원리
T A[N]; 은 연속된 메모리 덩어리를 잡고, A 는 시작 주소를 값으로 갖는 포인터가 된다.
A[i] 의 주소 = 시작주소 + (원소크기 x i)
배열 접근이 빠른 이유는, 어디 있는지 찾아다닐 필요 없이 계산 한 번으로 주소가 나온다.
포인터 연산
포인터 연산은 자동으로 스케일 된다. int *p 에서 p + 1 은 주소가 1 늘어나는게 아니라 4 늘어난다. 타입 크기만큼 자동으로 곱해진다.
C 에서 A[i] 는 *(A + i) 와 완전히 같은 말이다. 배열은 포인터 연산의 편의 표기이다.
중첩 배열 (2차원 배열)
int A[5][3] 은 길이 3짜리 배열이 5개이다. 메모리에는 한 줄씩 쭉 이어서 저장된다.
A[i][j]의 주소 = 시작주소 + 원소크기 x (열개수 x i + j)
여기서 i 에 곱해지는 게 행 번호가 아니라 열 개수이다. 한 행을 통째로 건너뛰어야 하니까. 2차원 배열은 행 방향으로 순회하는 게 열 방향보다 빠르다.
표로 보면:          선반(메모리)에 놓이면:
[1][2][3]          [1][2][3][4][5][6][7][8][9]
[4][5][6]           └ 0행 ┘ └ 1행 ┘ └ 2행 ┘
[7][8][9]
- 행 방향 순회 : 1 → 2 → 3 → 4 → 5 … 바로 옆 칸으로 한 칸씩 이동
- 열 방향 순회 : 1 → 4 → 7 → 2 → 5 … 여러 칸을 건너뛰며 왔다갔다 함
고정 크기 배열
배열 크기가 컴파일 시점에 정해져 있으면, 컴파일러는 루프 안의 A[i][j] 같은 계산을 곱셈없이 포인터를 조금씩 더하는 방식으로 바꿔 버린다. → 처음부터 주소 계산 X, 이전 주소에서 한 칸씩 이동
크기가 고정이면 컴파일러가 최적화한다.
가변 크기 배열
크기가 가변이면 곱셈이 실제로 필요하다. int A[n][n] 처럼 크기를 실행 시점에 정할 수 있다. n 이 상수가 아니면 진짜 곱셈 명령이 들어간다. 곱셈은 부분곱을 계속 계산해야해서 상대적으로 비싸다.
루프 안에서 규칙적으로 접근하면 컴파일러가 고정 크기 배열처럼 곱셈을 없애 주는 경우가 있다. 가변 배열 ≠ 무조건 느림.
이종 자료구조
C 의 struct/ union 문법이 기계어에서는 무엇이 되는가?
구조체
구조체는 서로 다른 타입의 필드를 연속된 메모리 영역 하나에 차례로 배치한 것이다. 구조체를 가리키는 포인터는 그 영역의 첫 바이트 주소이다.
struct rec {
    int i;
    int j;
    int a[2];
    int *p;
};

오프셋:  0      4      8             16            24
        |  i   |  j   | a[0] | a[1] |      p      |
컴파일러는 각 필드가 시작 주소로부터 몇 바이트 떨어져 있는지 (오프셋) 를 기억한다. r → j 에 접근하는 코드는 기계 수준에서 r 이 가리키는 주소 + 4 위치를 읽어라 가 된다. 배열 주소 계산을 그대로 사용하여, r→ a[i]는 r + 8 + 4 x i 위치 가 된다.
필드 선택은 전부 컴파일 시간에 처리된다. 완성된 기계어에는 다른 정보가 남지 않고, 숫자 오프셋만 남는다. 필드 이름은 사람과 컴파일러를 위한 것이고, CPU는 주소 + 상수만 본다.
- 필드 선택?
- 구조체 안에서 특정 멤버 하나를 골라 접근하는 것이다. C 코드에서 . 이나 → 를 쓰는 부분
공용체 (union)
struct 와 문법은 같지만 의미가 다르다. 공용체의 모든 필드는 같은 메모리 블록 (오프셋 O) 을 가리킨다. 한 메모리 조각을 여러 타입으로 바꿔 끼워서 해석하는 것이다.
⇒ 같은 데이터(바이트)를 다른 기계어로 읽는 것. 바이트는 그대로, 타입이 기계어를 바꾸고, 기계어가 해석을 바꾼다.
struct S3 { char c; int i[2]; double v; };
union  U3 { char c; int i[2]; double v; };
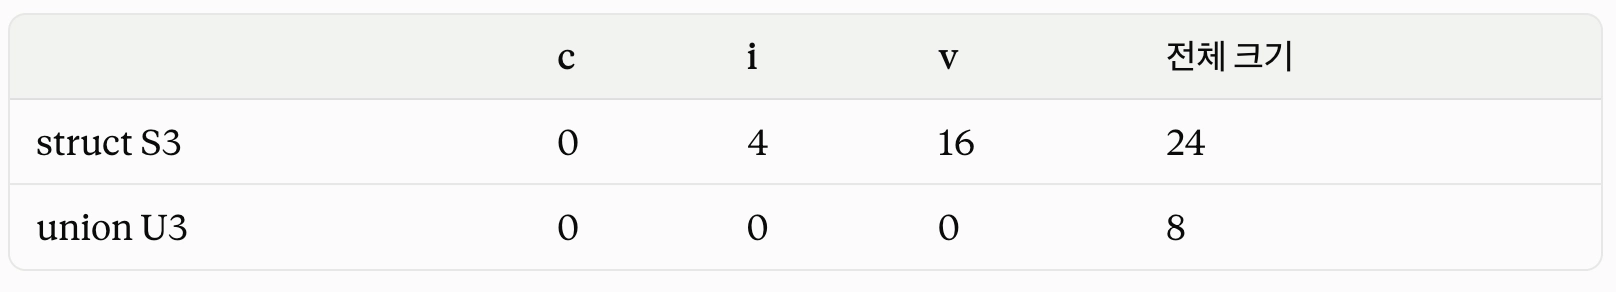
공용체의 크기는 가장 큰 필드의 크기가 된다. (정렬 요구도 반영됨)
struct라면:  [c][   i   ][  v  ]   → 전부 따로, 24바이트
union이라면: [ c / i / v 겹침 ]     → 전부 같은 자리, 8바이트

struct S (칸이 따로 있음)
주소:   100  101  102  103   104   105 106 107
       [  i 가 쓰는 4칸    ] [ c ] [ 패딩 3칸 ]
        ↑ i는 여기              ↑ c는 여기 (다른 자리)

union U (칸이 하나뿐)
주소:   100  101  102  103
       [        4칸        ]
        ↑ i도 여기서 시작, c도 여기서 시작 (같은 자리)
⇒ union 은 구조체와 비슷한데, 구조체처럼 내부의 모든 요소를 담을 수 없고 그 중 하나만 골라서 담음.
union U u;
u.i = 1;      // 4칸에 정수 1을 씀
u.c = 'A';    // 같은 칸의 첫 바이트를 65로 덮어씀
printf("%d", u.i);   // 1이 아님! 방금 덮어썼기 때문
union 을 선언할 때 하나만 쓸 거라고 미리 지정하는 문법은 없다. C 도 안 막아줌. 위 처럼 둘 다 쓰는 코드도 컴파일은 되지만, 같은 자리를 덮어써서 먼저 쓴 값이 깨진다.
- struct : 모든 필드를 동시에 담을 수 있다. → C 가 보장
- union : 하나만 유효하다 → 프로그래머가 지키는 약속
union 은 하나만 담아 주는 게 아니라, 공간을 하나만 주는 것임.
태그로 관리
태그는 지금 어느 멤버가 유효한지 기록하는 값이다. 타입과 유사하지만 C 의 타입 시스템은 아니고, 프로그래머가 직접 만들어서 직접 관리하는 표시값이다. union 자체는 자기 안에 뭐가 들었는기 기억을 안해서 필요함.
typedef enum { N_LEAF, N_INTERNAL } nodetype_t;   // ← 태그로 쓸 값의 종류

struct node_t {
    nodetype_t type;        // ← 태그: 이 노드가 리프인지 내부 노드인지
    union {
        struct {
            struct node_t *left;
            struct node_t *right;
        } internal;          // 내부 노드일 때 쓰는 필드
        double data[2];      // 리프일 때 쓰는 필드
    } info;                  // ← 겹쳐진 16바이트
};


// 사용할 때
if (n->type == N_LEAF)
    sum = n->info.data[0] + n->info.data[1];   // 리프니까 data를 꺼냄
else
    /* n->info.internal.left, right 사용 */ ;   // 내부 노드니까 포인터를 꺼냄
공용체의 용도
- 동시에 쓰이지 않는 필드로 메모리 절약
- 트리 노드에서 리프 노드는 값만, 내부 노드는 자식 포인터만 필요할 때.
- 같은 비트 패턴을 다른 타입으로 읽기
- double 을 넣고 unsinged long 으로 꺼내면, 값을 변환하는게 아니라 같은 0과 1을 다르게 쓰고 보는 것이다.
- 캐스팅 (unsingend long) d 는 변환이라 결과가 완전히 다르다.
왜 사용하는지
| 네 필드를 모두 struct 로 | 32 byte |
| union만 사용 (태그 X) | 16 byte |
| 태그 + union (실제 사용가능한 형태) | 24 byte |
32 → 24 byte 니까 25% 절약됨.
데이터 정렬 (주차 칸 규칙)
규칙 : K 바이트짜리 데이터는 K의 배수 주소에 둔다.
- int 4바이트 : 0,4,8,12 … 주소에서 시작
- double 8바이트 : 0,8,16 … 주소에서 시작
⇒ CPU가 정렬된 주소에서 읽는게 더 빠르다. CPU는 메모리를 한 칸씩이 아닌, 8 바이트 묶음 단위로 가져온다. double 이 하나의 칸 안에 있으면 한번에 가져오지만, 두개의 칸에 걸쳐 있으면 두 묶음을 가져와서 조립해야하기 때문에 느리다.
컴파일러가 알아서 맞춰 최적화를 해주는데, 이 때문에 구조체에 빈칸(패딩) 이 생긴다.
struct S1 { int i; char c; int j; };

[ i i i i ][ c ][ 빈 빈 빈 ][ j j j j ]
  0         4     5~7        8
c 뒤에 바로 j 를 두면 j 가 주소 5에서 시작하게 되는데, 5는 4의 배수가 아니다. 그래서 3칸을 비우고 8에서 시작함. 결과적으로 9 바이트가 아닌 12 바이트가 된다.
- 팁 : 큰 타입부터 선언하면 빈칸이 줄어든다.
3.10 제어와 데이터의 결합
3.1 ~ 3.9 (C 문법이 어떤 어셈블리로 바뀌는가) 에서 바뀐 것들이 (제어흐름 + 데이터+ 스택) 한 덩어리로 얽혔을 때 무슨 일이 벌어지는가를 다룬다.
스택에는 내 데이터(배열) 과 돌아갈 곳(리턴 주소) 이 바로 옆에 붙어 있고, C 는 배열 끝을 지켜주지 않는다. 그래서 데이터를 너무 많이 쓰면 돌아갈 곳이 바뀐다.
→ 리턴 주소도 결국 스택에 있는 그냥 데이터일 뿐
포인터
포인터는 기계어에서 주소 숫자다. C 에서는 int *, char * 처럼 타입이 있지만, 기계어에는 타입이 없다. 컴파일러가 타입을 보고 몇 바이트 읽을지, 몇 칸 건너뛸지를 미리 계산해서 명령어에 박아둔다.
- &x → x 의 주소를 계산만 한다.
- *p → 그 주소에 실제로 가서 읽거나 쓴다
- a[3]은 *(a+3) 과 같다. +3 은 원소 3개만큼 이동
버퍼 오버플로우
[ 리턴 주소 ]   ← 함수 끝나면 여기로 돌아감
[ ...       ]
[ char buf[8] ] ← 내 지역 배열gets(buf) 처럼 입력 길이를 확인하지 않는 함수로 8글자보다 긴 입력을 받으면, 넘친 글자가 위쪽(높은 주소) 으로 계속 덮어써지다가 리턴주소까지 바꿔버린다.
공격자는 이를 악용하여 입력에 자기가 만든 코드를 넣고, 리턴 주소를 그 코드 위치로 덮어쓴다. 함수가 끝나는 순간 공격자의 코드가 실행된다.
- gets 대신 fgets 처럼 최대 길이를 지정하는 함수 사용
fgets
- 최대 몇 글자까지만 읽을지 미리 정해주는 입력 함수이다. 버퍼보다 긴 입력이 들어와도 넘치지 않는다.
- 줄바꿈 \n 도 같이 저장된다.
char *fgets(char *buf, int size, FILE *stream);

buf : 읽은 문자열을 저장할 배열
size : 배열 크기 (size-1 글자까지 읽음)
stream : 어디서 읽을지
방어 기법 3가지
- 스택 랜덤화 (ASLR)
- 실행할 때마다 스택 위치를 무작위로 바꾼다.
- 공격자가 될때까지 하면 뚫림
- 카나리 (Stack Protector)
- 배열과 리턴 주소 사이에 무작위 값을 끼워두고, 함수가 끝나기 전에 값이 바뀌었는지 검사
- char 배열을 뒀을 때 gets 등을 써서 검사하는거 안 넣어서 문제가 발생. char 배열을 지역변수로 쓰고, gets 등 사용할 때만 시스템이 카나리 사용
- 실행 금지 영역 (NX)
- 스택을 읽기, 쓰기만 가능, 실행은 불가로 표시
- 스택 실행권한을 안줌. return 같은거는 코드 영역에 다 넣어놓음 실행할 수 있게.
하나로는 완벽하지 않아서 여러 겹으로 사용한다.
크기가 바뀌는 스택 프레임
보통 컴파일러는 함수가 스택을 얼마나 쓸지 미리 안다. 그런데 int arr[n]; 처럼 n 이 실행 중에 정해지면 미리 알 수 없다. 이때만 %rbp(프레임 포인터)라는 레지스터를 고정된 기준점으로 쓴다.
스택 꼭대기 (%rsp) 가 얼마나 움직이든, 지역 변수를 %rbp 기준으로 찾을 수 있게 한다. 평소에는 레지스터 아끼려고 안쓰고, 꼭 필요할 때만 쓴다.
3.11 부동소수점 처리
float/double 코드가 기계 수준에서 어떻게 처리되는지. 정수와 다른 전용 레지스터와 명령어로 처리됨.
실수는 전용 레지스터를 사용한다.
- 정수는 %rax, %rdi 같은 레지스터를 쓴다.
- 실수는 %xmm0 ~ %xmm15 라는 별도 레지스터를 쓴다.
실수는 IEEE754 형식 (부호, 지수, 가수) 라 계산 방식이 정수와 완전히 다르다.
함수 호출 규칙
정수와 같은 방식으로 자리만 다르다.
- 실수 인자는 %xmm0, %xmm1 순서로 전달된다. (최대 8개)
- 실수 반환값은 %xmm0 에 담긴다.
- 정수 인자와 실수 인자는 번호를 따로 센다.
double f(int x, double y);
// x → 정수 레지스터 1번째 (%edi)
// y → 실수 레지스터 1번째 (%xmm0)
형변환
int i = (int) 3.7; // 결과: 3 (소수점 버림)같은 숫자 3이라도 int 3과 double 3.0은 비트 모양이 완전히 다르다. 형변환할때마다 CPU가 변환 명령어를 실제로 실행한다.
실수 상수는 메모리에서 꺼내 온다
정수는 x + 5 의 5를 명령어 안에 바로 넣을 수 있다. 실수는 그렇게 할 수 없어서, 1.8 같은 상수를 메모리에 미리 저장해 두고 읽어서 사용한다.
비교할 때 NaN이 문제다
정수 비교 결과는 작다, 같다, 크다 세가지 뿐이다. 실수에는 NaN(Not a Number, 0.0/0.0)이 있다. NaN 은 어떤 값과 비교해도 거짓이 나온다. 자기 자신과도 같지 않다.
실수 비교에는 비교불가라는 네 번째 결과가 생긴다. CPU 는 이를 표시하는 플래그(PF) 를 추가로 사용한다.
⇒ C의 if (x < y) 하나가 실수에서는 NaN 처리까지 포함한 더 복잡한 분기로 바뀔 수 있다.
- NaN 과의 비교는 비교불가라서 항상 거짓이다. 이것이 위험한 이유는, 조용히 틀리기 때문이다. (에러가 아닌 거짓을 돌려주기 때문에)
- 비교 전에 NaN인지 먼저 확인하는 것으로 예방.